ローカルLLMの長文処理
ローカルLLMが長文で急に遅くなるのはなぜ?VRAMとコンテキスト長を確認
公開日:2026-09-10 著者:組立テルノ
結論:「返答前に待つ」と「書き出してから遅い」を分けよう
選部マヨ子
組立テルノ
選部マヨ子
組立テルノ
LM Studioに長い資料や会話履歴を渡すと、返答までの待ち時間が増えることがあります。ただし、長文で遅いというだけでは、VRAM不足やCPU実行への切り替わりを断定できません。
手元のQwenモデルで6条件を各3回測定すると、入力489トークンでは最初の本文受信まで約0.36秒、27,076トークンでは約6.43秒。その後の生成速度は、入力長を比較した4条件の中央値で約137〜142トークン/秒でした。
この記事では、この実測と、Context Lengthを大きくしたときのGPUメモリ使用量を紹介します。VRAM不足による急落を再現した記事ではありません。遅さの原因を切り分けるためのガイドとして読んでください。
1. 「読む時間」と「答えを書く時間」は別
長い資料を渡した直後は、モデルが入力を処理します。その後、返答を順番に生成します。前者が入力処理(プロンプト処理)、後者が文章の生成です。
返答前の待ち時間には、入力処理以外にモデルの読み込みや、Think・reasoningの処理などが入る場合もあります。何も表示されていない時間を、すべてVRAM不足による停止と考えないようにしましょう。
- 返答が始まるまで長い
- 入力処理中か、モデルをロード中か、推論中かを確認。長い本文や会話履歴も見直します。
- 書き出した後も遅い
- 生成速度と、生成中のGPU・メモリ使用量を確認。モデルやGPU割り当てなどの条件も比べます。
処理段階の区別:LM Studio公式 Streaming events。公式APIでもモデルロード、入力処理、推論、本文出力は別イベントです。
選部マヨ子
組立テルノ
2. 長文では、返答開始まで約0.36秒から6.43秒へ
同じモデルと設定で、合成した日本語のPC作業記録を長くして比較しました。Context Lengthの上限は32,768に固定。毎回モデルを読み直し、別の短い質問でウォームアップしてから測っています。
各条件3回の中央値です。モデルのロード時間とウォームアップは表に含めていません。出力は全回256トークンで終了させ、入力文のキャッシュ再利用がないことをエンジンログと照合しました。
| 実入力 トークン数 | 入力処理 時間 | 最初の本文 受信まで | 生成速度 トークン/秒 |
|---|---|---|---|
| 489 | 0.316秒 | 0.363秒 | 139.8 |
| 3,382 | 0.890秒 | 0.933秒 | 141.8 |
| 13,508 | 3.018秒 | 3.435秒 | 140.9 |
| 27,076 | 6.069秒 | 6.433秒 | 137.2 |
入力処理時間と、最初の本文受信までは別の計測値
入力処理はエンジンログのprompt eval時間です。「最初の本文受信まで」は測定プログラムが送信を開始してから最初の本文を受け取るまでで、通信・配信などの待ちも含みます。LM StudioのAPIが返したTTFT値は、今回の環境では入力処理時間と一致したため、そのまま体感の待ち時間としては使っていません。
長文条件では、入力処理に約6.07秒かかりました。一方、生成速度は137.2トークン/秒で、短い入力の139.8トークン/秒から桁が変わるような低下は起きていません。
つまり今回確認できたのは、「入力が長いほど返答前の待ちが増えた」ことです。どのモデルでも長文の生成速度が変わらない、という結論ではありません。
選部マヨ子
組立テルノ
3. 入力文の長さと、Context Lengthの上限は違う
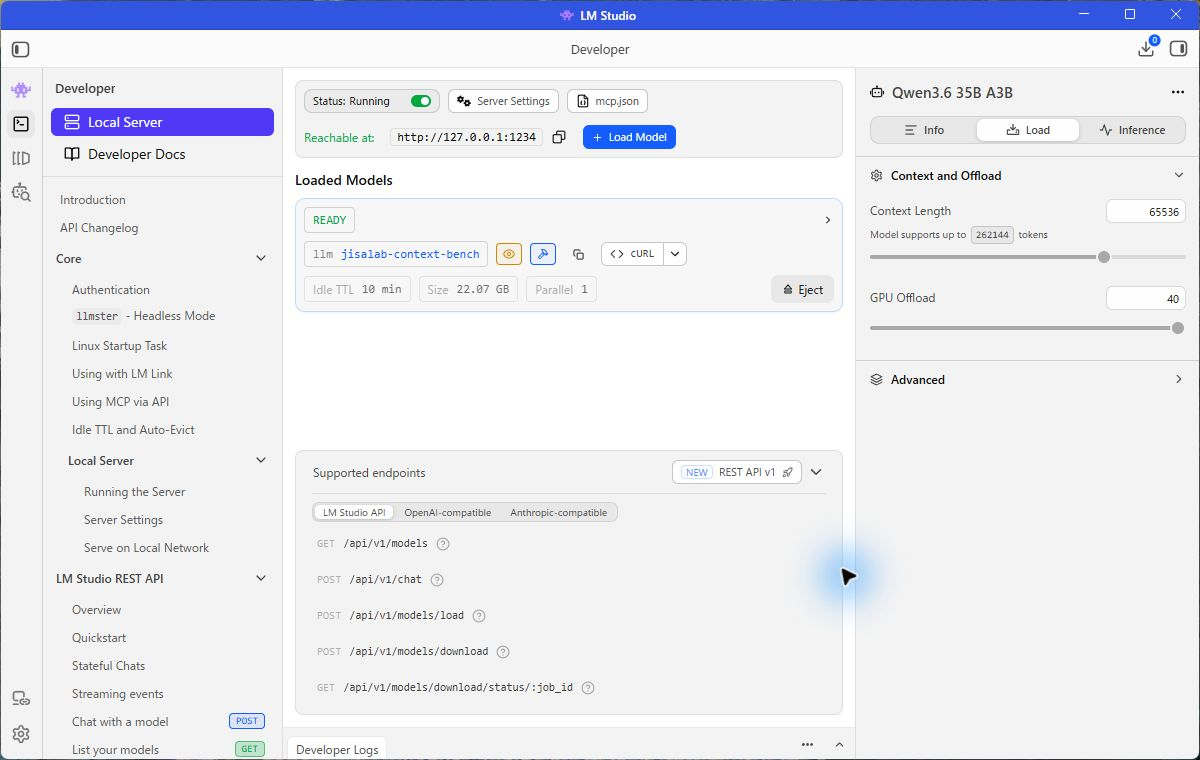
実際の入力長は、今回モデルに渡す文章の量。Context Lengthは、ロード時に設定する、扱える文脈の長さの上限です。会話履歴や指示文も文脈に入り、回答を生成する余地も必要です。
たとえば上限が32,768でも、短い質問を送るたびに32,768トークン全部を読むわけではありません。ただし、扱える上限を大きくすると、実行時に確保するメモリが増えることがあります。
そこで今度は、入力を489トークンに固定し、上限だけを変えてロード前後のGPUメモリを比べました。
| Context Length | RTX 5080 | RTX 4080 SUPER |
|---|---|---|
| 8,192 | 10,221 MiB | 11,841 MiB |
| 32,768 | 10,421 MiB | 12,177 MiB |
| 65,536 | 10,915 MiB | 12,625 MiB |
RTX 4080 SUPERは毎回ロード前が0MiBで、上限8,192から65,536へ増やしたときの差は784MiB、約0.77GiBでした。短い入力でも、上限設定によってロード時の使用量が変わっています。
これはGPU全体の使用量です。特にRTX 5080は画面表示などにも使っているため、背景の使用量が動きます。LM Studio単独の使用量や、KVキャッシュだけの容量として読まないでください。MiB・GiBはメモリ容量の単位で、1GiB=1,024MiBです。
モデルのファイルサイズだけでは、必要VRAMは決まらない
モデル本体に加え、計算用の領域や、過去のトークンの計算結果を再利用するKVキャッシュなどもメモリを使います。文脈が長くなると、保持する情報の負担も変わります。
確保の仕方はモデル構造・実行エンジン・設定によって異なるため、「上限を2倍にすれば、PC全体の必要メモリも必ず2倍」といった計算はできません。今回の約0.77GiBという差も、ほかのモデルへそのまま当てはめないでください。
仕組みの参考:Hugging Face公式 KVキャッシュの説明。今回の測定エンジンはTransformersではなくllama.cppです。
選部マヨ子
組立テルノ
設定とメモリ見積もり:LM Studio公式 lms load。公式の見積もりもContext Lengthなどの設定を考慮します。
4. 本当に生成が急落したら、VRAMと処理の割り当てを確認
ここからは今回再現した結果ではなく、別の環境で遅さを調べるための確認項目です。入力処理の待ちだけでは説明しにくい場合に見てください。
専用GPUメモリと共有GPUメモリは別物
Windowsのタスクマネージャーで「パフォーマンス」からGPUを開き、専用GPUメモリと共有GPUメモリを見ます。今回のような単体グラボでは、専用側がグラボ上のVRAM、共有側がGPUからも利用するシステムRAMです。
共有側の表示が増えても、グラボに高速なVRAMが増設されたわけではありません。ただし、共有メモリが使われているだけで原因を確定しないこと。短い入力と長い入力で、遅くなる時刻と一緒に変化するかを確認します。
表示の意味:Microsoft公式 タスクマネージャーのGPUメモリ説明。今回の測定では共有GPUメモリは記録していません。
CPUへの割り当てと、ドライバーのメモリ退避を混同しない
GPU Offloadが少ない構成では、モデルの一部をCPU側で処理する場合があります。これはGPUの計算を続けながらシステムRAMを利用する仕組みとは別です。「VRAMが埋まると、必ずその瞬間にCPU実行へ切り替わる」とは考えないでください。
NVIDIAはStable Diffusion向けの公式解説で、GPUメモリが不足した際の共有メモリへのフォールバックと、その速度低下を説明しています。ただし、今回のLM Studioでその現象が発生したことを示すものではありません。動作はドライバーやエンジンなどにも依存します。
原因を確認する前に、その退避機能を無効化するのはおすすめしません。メモリが足りないとエラーや停止になる可能性があります。まずは入力・上限設定・同時実行を小さくして比較しましょう。
参考:NVIDIA公式 System Memory Fallback for Stable Diffusion。別アプリ向けの説明を仕組みの参考として参照しています。
GPUを使えているかの基本確認は、LM StudioでGPUが使われない?CPU実行になっているか確認する方法で実画面付きで解説しています。
5. 設定を一度に変えず、この順番で比べよう
- 短い新規チャットを基準にする。モデル・量子化・Thinkの状態・電力制限を控えます。モデルのロード完了を待ってから、短い質問で返答前の待ちと生成速度を記録します。
- 実際に渡す文章を増やして比べる。同じモデルと設定で、必要な長文を入力。長い会話だけ遅いなら、必要な前提をまとめて新しいチャットへ渡す比較もできます。元の会話は消さず、要約の抜けを確認してください。
- Context Lengthを必要な範囲にする。入力・会話履歴・回答の余地を残しつつ、過大な上限を見直します。変更後はその設定でモデルを再ロードし、GPUメモリの変化を見ます。下げすぎると入力が収まらないので注意してください。
- GPU割り当てとメモリを確認する。GPU Offload、生成中の専用・共有GPUメモリ、PC全体のRAMを確認。メモリ使用量だけでなく、生成中の負荷も合わせて見ます。
- 同時作業を減らしてから再比較する。画像生成、ゲーム、別モデルのロードなどを見直します。作業を保存して停止し、不要なモデルも解放。まだ厳しければ小さいモデルなどを検討しますが、回答品質も別に確認してください。
選部マヨ子
組立テルノ
同じ質問の繰り返しではキャッシュなどで条件が変わる場合があります。「2回目だけ速かった」を入力長の効果と混同しないように、再ロードの有無も記録しておくと比較しやすくなります。
測定条件
- 測定日・アプリ
- 2026年9月8日 / Windows / LM Studio 0.4.23(Build 1)
- CPU・RAM
- Ryzen 9 9950X / OSから見える物理RAM:約125.52GiB
- GPU・電力上限
- RTX 5080 16GB:250W / RTX 4080 SUPER 16GB:160W。制限を維持して測定。
- モデル
- Qwen3.6 35B A3B / Q4_K_M / GGUF 22,069,769,172バイト(約22.07GB)
- エンジン・ドライバー
- llama.cpp CUDA12 AVX2 2.33.0 / NVIDIA 596.36
- ロード設定
- GPU Offload最大(40)/ Parallel 1 / Flash Attentionオン / KVキャッシュのGPU配置オン
- 生成設定
- Think・reasoningオフ / temperature 0 / Speculative Decodingオフ / 最大出力256トークン
- 測定方法
- ローカルAPI経由。6条件×3回=18回。毎回再ロード後に別の短い質問でウォームアップ(集計外)。入力長比較と上限比較で32,768・489トークンの条件を共用。
- データ
- 本測定18回の数値CSV。contextは上限、input_tokensは実入力数。時間は秒、GPUメモリはMiB、RAMはGiB。本文の表は中央値です。
まとめ:グラボを替える前に、どこで待っているかを見る
今回、長文で増えたのは主に返答前の入力処理時間でした。短い質問でもContext Lengthの上限を増やすと、ロード時のGPUメモリ使用量は増加。実際の入力長と、扱える上限設定の両方を見るのがポイントです。
まず短い新規チャットと比較し、待ち時間と生成速度を分けて記録する。それからGPUの設定とメモリを確認しましょう。PCの構成を見直すのは、その後でも遅くありません。
FAQ
よくある質問
長文で遅くなったら、VRAM不足で確定?
選部マヨ子
Q1
組立テルノ
Context Lengthは最大にしておいた方がいい?
選部マヨ子
Q2
組立テルノ
新しいチャットにすれば、前の会話も覚えたまま軽くなる?
選部マヨ子
Q3
組立テルノ
パワーリミットは解除した方がいい?
選部マヨ子
Q4
組立テルノ
参考情報
公式資料の確認日:2026年9月10日。本文の実測は2026年9月8日の記録です。画面はバージョンにより変わります。サムネイルのキャラクターとタブレット画面は説明用イラストで、測定画面ではありません。